Claude Fable 5.2 ist da und übertrifft Opus 5.5 in (fast) allen Bereichen
Claude Fable 5.2 übertrifft Anthropics Standardmodell Claude Opus 5.5 in fast allen Bereichen, die der Hersteller getestet hat, vom Agentic Coding über Bilderkennung bis zur Robotersteuerung. Laut der offiziellen Ankündigung erreicht Fable 5.2 im Coding-Test FrontierCode 2.0 schon auf der Effort-Stufe High das Niveau von Opus 5.5 auf Max und braucht dafür nur etwa die Hälfte der Kosten pro Aufgabe.
Zugleich wird Fable 5.2 günstiger: Seit dem 9. November 2026 kostet es $8 / $40 statt $10 / $50 pro Million Token und erzeugt Text laut Anthropic bis zu 30 % schneller als Fable 5.1. Parallel startet Claude Mythos 5.2, technisch dasselbe Modell mit weniger Schutzfiltern, das nur geprüfte Organisationen bekommen. Wir haben uns angeschaut, wo Fable 5.2 vor Opus 5.5 liegt, was es kostet und wann Opus 5.5 trotzdem die bessere Wahl bleibt.
Claude Fable 5.2 Benchmarks: fast überall vor Opus 5.5
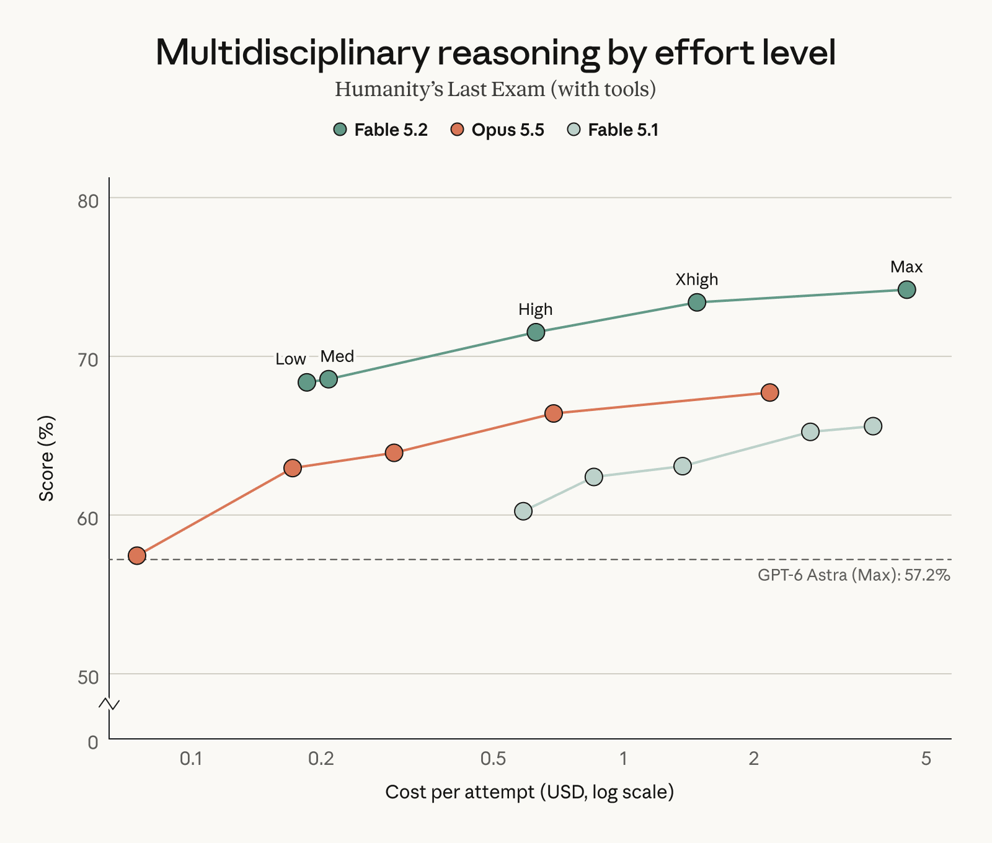
Alle Werte zum Start stammen von Anthropic, gemessen mit der jeweils höchsten verfügbaren Effort-Stufe. Bei Humanity’s Last Exam mit Tools kommt Fable 5.2 laut Anthropic auf 74,2 %, Opus 5.5 auf 67,7 %, Fable 5.1 auf 65,6 % und GPT-6 Astra auf 57,2 %. In unserer Rangliste darunter steht GPT-6 Astra mit 54,8 %; dieser Wert stammt nicht von OpenAI selbst.
- Platz 1
 Claude Fable 5.2Anthropic
- Platz 2Claude Opus 5.5Anthropic
- Platz 3Claude Fable 5.1Anthropic
- Platz 7
 GPT-6 AstraOpenAI
- Platz 9GPT-6.1 SolOpenAI
Im Coding-Test FrontierCode 2.0 prüft Anthropic, ob Maintainer von Open-Source-Projekten die Code-Änderungen eines Modells übernehmen würden. Auf der Stufe Xhigh erreicht Fable 5.2 dort 49,1 %, laut Anthropic der beste Wert aller getesteten veröffentlichten Modelle. Schon auf High liegt es mit 45,3 % praktisch gleichauf mit dem Bestwert von Opus 5.5 (45,5 %).
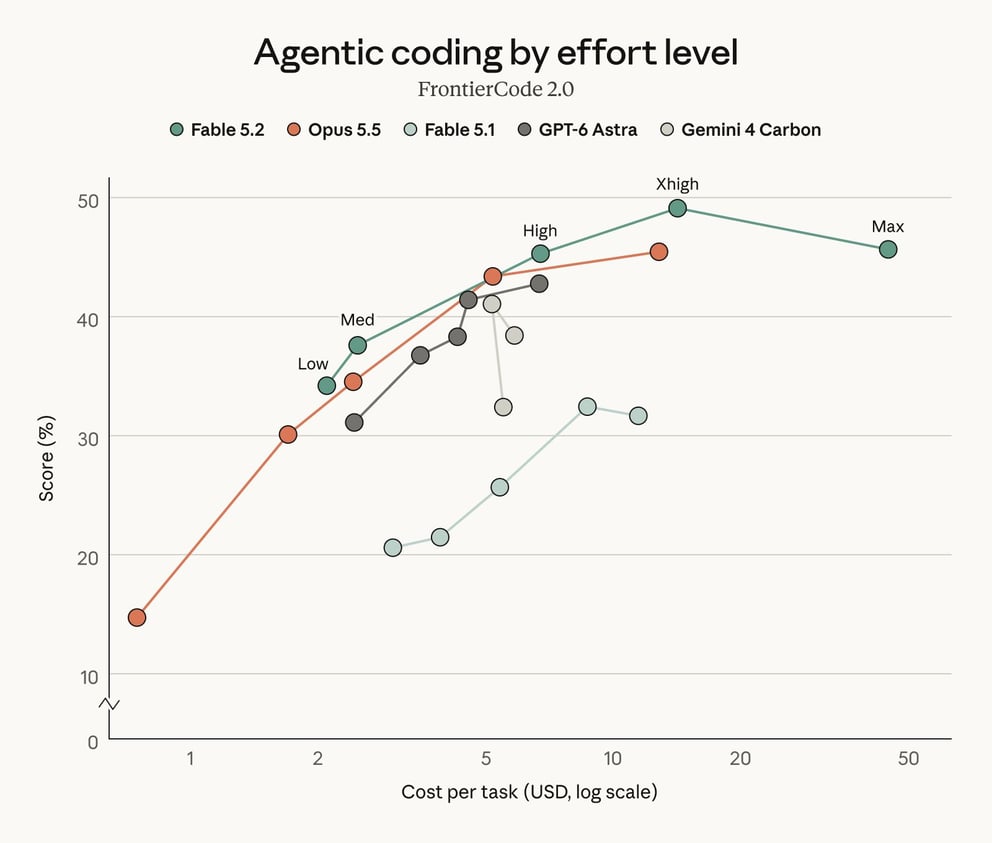
FrontierCode 2.0
| % | |
|---|---|
| Fable 5.2 (Xhigh) | 49,1 |
| Opus 5.5 | 45,5 |
| Fable 5.2 (High) | 45,3 |
| GPT-6 Astra | 42,8 |
| Gemini 4 Carbon (Medium) | 41,1 |
| Fable 5.1 (Xhigh) | 32,4 |
Den größten Sprung zeigt die Robotersteuerung in RoboDojo Sim, einem Test, den Anthropic selbst ausgeführt hat: 64,9 % statt 27,6 % bei Fable 5.1. Ganz vorn liegt Fable 5.2 aber nicht überall. Beim Test für Geschäftsabläufe AutomationBench führt Gemini 4 Carbon mit 53,9 % zu 51,4 %.
RoboDojo Sim
| % | |
|---|---|
| Fable 5.2 | 64,9 |
| Opus 5.5 | 39,4 |
| GPT-6 Astra | 29,8 |
| Fable 5.1 | 27,6 |
Weitere Benchmarks im Vergleich
| FrontierSWE v2 | Terminal-Bench-Science 0.1 | AutomationBench | Chartography | |
|---|---|---|---|---|
| Fable 5.2 | 69,9 % | 74,6 % | 51,4 % | 73,4 % |
| Fable 5.1 | 56,3 % | 52,6 % | 31,4 % | 44,8 % |
| Opus 5.5 | 62,3 % | 58,7 % | 42,5 % | 64,4 % |
| GPT-6 Astra | 65,5 % | 68,1 % | 41,4 % | 71 % |
| Gemini 4 Carbon | 61,2 % | 64,8 % | 53,9 % | 72,5 % |
Claude Fable 5.2: Preis und Fast Mode
Laut Preisliste kostet Fable 5.2 $8 pro Million Input-Token und $40 pro Million Output-Token, 20 % weniger als Fable 5.1. Über die Batch-API halbiert sich der Preis auf $4 / $20. Mythos 5.2 kostet dasselbe wie Fable 5.2.
Neu ist ein optionaler Fast Mode, der die Ausgabe laut Anthropic bis zu 2,5-mal beschleunigt. Er kostet $16 / $80, funktioniert nicht mit der Batch-API und ist in Claude Code, auf der Claude Platform, bei Google Cloud und in Microsoft Foundry (von Anthropic gehostet) verfügbar. Bei Mythos 5.2 steht er nur Organisationen aus den Verifizierungsprogrammen offen.
Preise pro Million Token
| Input | Output | |
|---|---|---|
| Fable 5.1 | 10 $ pro 1 Mio. Token | 50 $ pro 1 Mio. Token |
| Fable 5.2 | 8 $ pro 1 Mio. Token | 40 $ pro 1 Mio. Token |
| Fable 5.2 Fast Mode | 16 $ pro 1 Mio. Token | 80 $ pro 1 Mio. Token |
Fable 5.2 oder Mythos 5.2: Was ist der Unterschied?
Laut Anthropic laufen beide auf demselben Modell. Fable blockiert per Klassifikator riskante Cyber-Aufgaben wie Penetrationstests und Exploit-Entwicklung sowie die meisten Aufgaben aus der biologischen Forschung. Solche Anfragen beantwortet dann Opus 4.8 (Cyber) oder Opus 5 (Biologie). In frühen Tests blockierte Fable 5.2 laut Anthropic rund 55 % weniger Anfragen als Fable 5.1.
Mythos 5.2 ohne diese Sperren bekommen nur Organisationen, die über das Cyber Verification Program oder das Life Sciences Verification Program zugelassen sind. Enterprise-Kunden nutzen Claude Mythos 5.2 außerdem indirekt über Claude Security, das Codebasen nach Schwachstellen durchsucht. Im internen Test CVE Rediscovery findet Mythos 5.2 laut Anthropic 10,2 % mehr Schwachstellen als Opus 5.5.
CVE Rediscovery
| % | |
|---|---|
| Mythos 5.2 | 89,6 |
| Opus 5.5 (ohne Safeguards) | 81,3 |
| Mythos 5.1 | 78,3 |
Ist Claude Fable 5.2 in Deutschland verfügbar?
Fable 5.2 steht seit dem 9. November in allen bezahlten Claude-Abos bereit, dazu in Claude Code, über die Claude Platform mit der Modell-ID claude-fable-5-2 sowie bei Amazon Web Services, Google Cloud und Microsoft Azure. Ausnahmen für die EU oder einzelne Länder nennt Anthropic nicht.
In der Startwoche setzt Anthropic das Fable-Kontingent je nach Abo-Dauer ein- bis dreimal zurück. Im Pro-Plan und auf Standard-Plätzen im Team-Plan darf Fable bis zu 50 % des wöchentlichen Nutzungslimits ausmachen. Mehr zu den Claude-Apps steht in unserem Claude-Ratgeber.
30 Tage Datenspeicherung
Für die Sicherheitsüberwachung bewahrt Anthropic bei Fable 5.2 Daten standardmäßig 30 Tage auf. Zero Data Retention behalten nur berechtigte Kunden; dafür sieht Anthropic Enterprise Frontier Safeguards vor, das sich in einer privaten Beta befindet.
Für wen lohnt sich Fable 5.2 statt Opus 5.5?
Anthropic empfiehlt für die meisten Coding- und Wissensaufgaben weiter Opus 5.5 als Standard, pro Token kostet es die Hälfte. Fable 5.2 ist laut Modellübersicht für anspruchsvolles Reasoning und lange Agenten-Aufgaben gedacht oder für Fälle, in denen Opus 5.5 auch mit hohem Effort nicht reicht.
Der doppelte Tokenpreis heißt nicht automatisch doppelte Kosten: Bei FrontierCode erreichte Fable 5.2 auf High laut Anthropic das Niveau von Opus 5.5 auf Max, zu etwa halben Kosten pro Aufgabe. Baust du eigene Agenten, kannst du Fable auch als Advisor einsetzen, den Haiku, Sonnet oder Opus bei schweren Problemen fragen, oder als Orchestrator, der einfache Aufgaben an kleinere Modelle verteilt.
| Merkmal | Claude Fable 5.2 | Claude Opus 5.5 |
|---|---|---|
| Preis pro 1 Mio. Token (Input / Output) | $8 / $40 | $4 / $20 |
| Fast Mode | $16 / $80 | $8 / $40 |
| Batch-API | $4 / $20 | $2 / $10 |
| Kontextfenster | 1 Mio. Token | 1 Mio. Token |
| Maximale Ausgabe | 128K Token | 128K Token |
| Einsatz laut Anthropic | Anspruchsvolles Reasoning, lange Agenten-Aufgaben | Standard für die meisten Coding- und Wissensaufgaben |
Für Alltagsaufgaben bleibt Opus 5.5 damit der sinnvolle Startpunkt. Fable 5.2 lohnt sich für Teams, die an großen Software-Migrationen, langen Agenten-Läufen oder wissenschaftlichen Problemen arbeiten und dort mit Opus an Grenzen stoßen.