Google veröffentlicht mit Gemini Decision 1 sein erstes Decision Model ohne Output-Kosten
Googles neues Modell schreibt keinen einzigen Satz: Gemini Decision 1 wählt nur aus Antworten, die du vorgibst, und gibt dazu Wahrscheinlichkeiten zurück. Für Entwickler heißt das laut der offiziellen Ankündigung vom 11. November 2026: Entscheidungen wie Tool-Auswahl oder Routing, für die bisher ein Sprachmodell erst Text erzeugen musste, kosten nur noch Input-Token, denn den Output berechnet Google nicht.
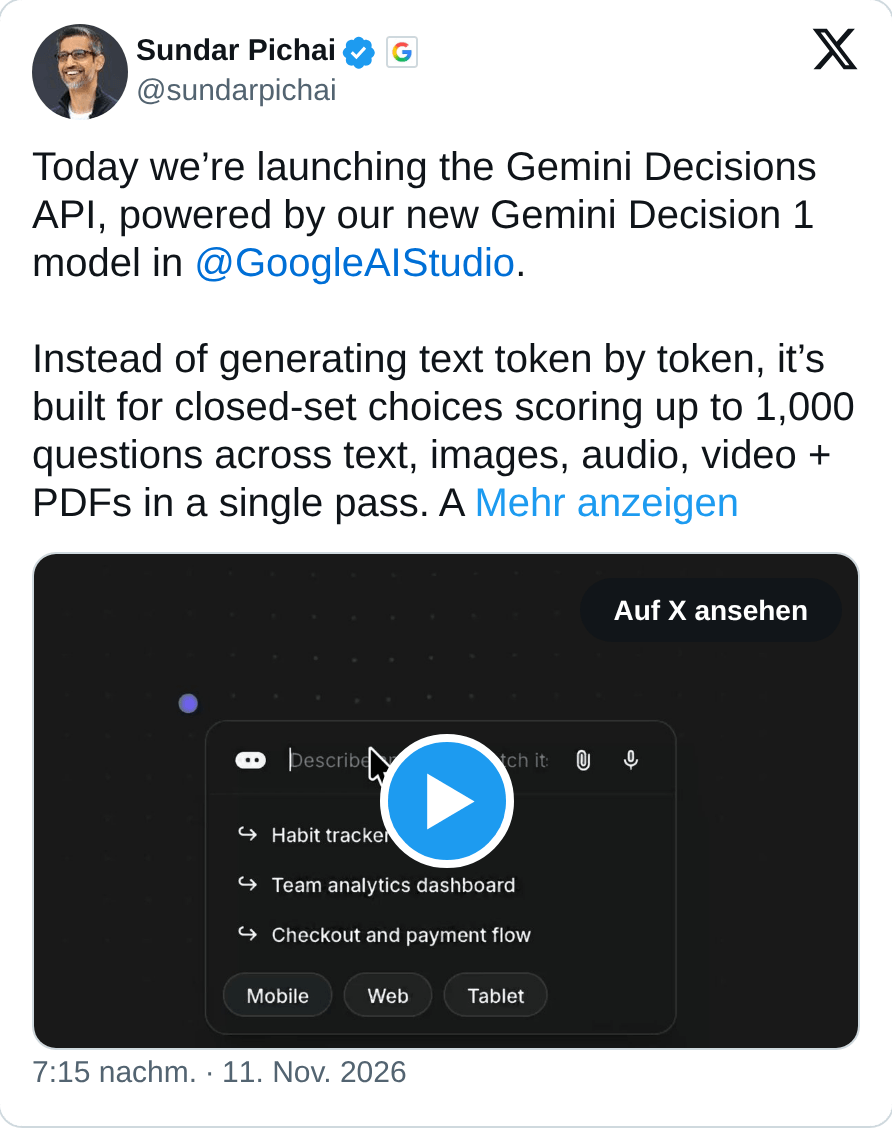
Gemini Decision 1 ist Googles erstes Entscheidungsmodell und läuft über die neue Gemini Decisions API. Es beantwortet bis zu 1.000 Ja/Nein-, Auswahl- und Bewertungsfragen in einem Durchgang, auch zu Bildern, Audio, Video und PDFs. Wir erklären, wie das funktioniert, was es kostet, was die Benchmarks zeigen und wie Google gegen Jev und OpenAI dasteht.
Das Wichtigste in Kürze
- Entscheiden statt schreiben: Gemini Decision 1 bewertet vorgegebene Optionen in einem einzigen Forward Pass und gibt zu jeder Antwort einen Konfidenzwert von 0 bis 1 zurück.
- Preis: $0,10 pro Million Input-Token, Output-Token kosten nichts; über Googles Benchmark-Suite ist das laut Google fast fünfmal günstiger als Gemini 3.5 Flash-Lite.
- Tempo: 150 bis 250 ms Ende-zu-Ende bei Kontexten bis 16K Token, nahezu gleich bei einer oder 100 Fragen pro Anfrage.
- Benchmarks: In Googles Vergleich liegt das Modell in 7 von 9 Tests vorn und hat den niedrigsten Kalibrierungsfehler; zwei Tests, darunter Tool-Call-Entscheidungen, gewinnt Jev 1.14.
- Verfügbarkeit: Zum Start über die Gemini API in Google AI Studio (v1beta) mit Gratis-Stufe und über OpenRouter; Google Cloud soll bald folgen.
Wie funktioniert Gemini Decision 1?
Ein klassisches Sprachmodell erzeugt seine Antwort Token für Token. Soll eine App nur entscheiden, ob eine Mail Spam ist oder welchem Agenten eine Aufgabe zufällt, muss sie den generierten Text danach wieder in einen Wert übersetzen. Gemini Decision 1 spart sich diesen Umweg: Es bewertet die vorgegebenen Optionen in einem einzigen Forward Pass und gibt Wahrscheinlichkeiten und Konfidenzwerte zurück.
Jede Anfrage besteht aus einem gemeinsamen Input und bis zu 1.000 unabhängigen Fragen. Der Input darf Text, Bilder, Audio, Video und PDFs mischen und bis zu 256K Token lang sein, etwa eine Gesprächsaufzeichnung mit Kontodaten oder ein gescannter Schadensantrag mit Fotos. Bei Bildern und Videos stellst du die Auflösung ein und steuerst damit Detailgrad und Token-Kosten.
So läuft eine Anfrage an Gemini Decision 1
- Gemeinsamer Input – Text, Bild, Audio, Video oder PDF, zusammen bis 256K Token
- Bis zu 1.000 Fragen – Ja/Nein (noul), Auswahl (choice) und Bewertung (score) gemischt
- Ein Forward Pass – Optionen werden bewertet, statt Text Token für Token zu erzeugen
- Wahrscheinlichkeiten und Konfidenz – Je Antwort ein Konfidenzwert von 0 bis 1, keine Output-Token
- Dein Code entscheidet – Sichere Fälle automatisch, unklare an Reasoning-Modell oder Mensch
Die Fragen sehen einander nicht und laufen parallel. Deshalb bleibt die Latenz laut Google nahezu gleich, ob du eine oder 100 Fragen stellst. Mit dem Konfidenzwert kann dein Code sichere Antworten direkt umsetzen und unklare Fälle an ein Reasoning-Modell oder einen Menschen weitergeben.
Philipp Schmid, Google, auf dev.to (übersetzt)Generative Modelle schreiben Text, den Menschen lesen. Wenn deine App nur ein Tool auswählen oder eine Anfrage weiterleiten muss, bringt ein Chatmodell, das JSON liefern soll, zusätzliche Latenz und anfälligen Parsing-Code, den du eigentlich nicht pflegen müssen solltest.
Drei Entscheidungstypen: Ja/Nein, Auswahl und Bewertung
Alle drei Fragetypen lassen sich in einer Anfrage mischen. Google nennt als typische Aufgaben Tool-Auswahl, Policy Checks, Modell-Routing und das Bewerten von Kontext.
| Typ | Name in der API | Was zurückkommt |
|---|---|---|
| Ja/Nein | noul | Wahrscheinlichkeit, dass die Bedingung zutrifft; optional mit Kriterien für wahr und falsch |
| Auswahl | choice | Gewinner aus 2 bis 255 Optionen plus normalisierte Wahrscheinlichkeit für jede Option |
| Bewertung | score | Gewichteter Wert auf einer geordneten Skala ab 0 plus Wahrscheinlichkeit je Stufe |
Googles Beispiel prüft das Foto einer Küchenzeile im Pausenraum mit allen drei Typen: ob etwas verschüttet ist, welche Reinigung passt und wie schwer die Verschmutzung ist. Zu jeder der drei Antworten liefert das Modell einen Konfidenzwert zwischen 0 und 1.
1from google import genai
2
3client = genai.Client(http_options={"api_version": "v1beta"})
4
5result = client.decisions.create(
6    model="gemini-decision-1",
7    input=[{
8        "type": "image",
9        "uri": "https://storage.googleapis.com/generativeai-downloads/images/spill.jpg",
10        "mime_type": "image/jpeg",
11    }, {
12        "type": "text",
13        "text": "Breakroom counter check before the 9 AM client meeting.",
14    },
15    ],
16    questions={
17        "has_spill": {
18            "type": "noul",
19            "instructions": "Is there an uncleaned liquid spill on the counter?",
20        },
21        "next_action": {
22            "type": "choice",
23            "instructions": "Which cleanup action fits the scene?",
24            "criteria": {
25                "wipe_with_cloth": "Small counter spill with a cloth or towel already nearby.",
26                "dispatch_janitorial": "Large floor hazard, broken glass, or active leak.",
27                "ready_for_meeting": "Counter is clean and ready.",
28            },
29        },
30        "severity": {
31            "type": "score",
32            "instructions": "Rate the severity of the counter mess.",
33            "criteria": [
34                "Clean and ready.",
35                "Minor localized spill.",
36                "Major spill or safety hazard.",
37            ],
38        },
39    },
40)
Ein Beispiel von uns zeigt, wie sich das auf den Alltag übertragen lässt: Ein Online-Shop will eingehende Kundenmails vorsortieren. Statt ein Chatmodell um JSON zu bitten und die Antwort zu parsen, stellt er Decision 1 zu jeder Mail drei Fragen in einer Anfrage:
- Ja/Nein (
noul): Will die Person etwas zurückgeben oder reklamieren? - Auswahl (
choice): Welches Team ist zuständig: Versand, Rechnung, Technik oder Sonstiges? - Bewertung (
score): Wie dringend ist die Mail, auf einer Skala von 0 (kann warten) bis 2 (sofort)?
Antworten mit hoher Konfidenz leitet der Shop direkt ins passende Postfach weiter, unsichere Fälle sieht sich ein Mensch an. Ein generatives Modell braucht er erst, wenn jemand eine Antwort an die Kundschaft formulieren soll.
Gemini Decision 1: Preis und Latenz
Gemini Decision 1 kostet $0,10 pro Million Input-Token, Output-Token kosten nichts. Den gemeinsamen Input berechnet Google pro Anfrage nur einmal, egal wie viele Fragen du stellst; jede Frage bringt nur ihre eigenen Anweisungen und Kriterien als Token mit. Kosten für Thinking-Token, Audio-Transkription oder OCR fallen nicht an, und bei OpenRouter gilt derselbe Preis.
| Merkmal | Gemini Decision 1 |
|---|---|
| Modell-ID | gemini-decision-1 |
| Input-Preis | $0,10 pro 1 Mio. Token |
| Output-Preis | $0 |
| Kontext | bis 256K Token |
| Fragen pro Anfrage | bis 1.000 |
| Optionen pro Auswahlfrage | 2 bis 255 |
| Latenz (Kontext bis 16K Token) | 50–100 ms Rechenzeit im Median, 150–250 ms Ende-zu-Ende |
Laut Google ist Decision 1 fast fünfmal günstiger als Gemini 3.5 Flash-Lite. Der Faktor bezieht sich nicht auf den Preis pro Token, sondern auf die Kosten über Googles eigene Benchmark-Suite im Vergleich mit Flash-Lite über die Interactions API. Er entsteht vor allem, weil keine Output-Token anfallen. Wie viel du sparst, hängt also davon ab, wie viele Fragen du pro Input stellst und wie viel Text dein bisheriges Modell erzeugt; überschlagen kannst du das mit unserem LLM-Kostenrechner.
Bei der Latenz nennt Google im Median 50 bis 100 ms Rechenzeit und 150 bis 250 ms Ende-zu-Ende. Diese Werte gelten für Kontexte bis 16K Token; für große Inputs bis 256K Token oder lange Videos nennt Google keine Zahl.
Wofür nutzt Google die Decisions API schon?
Google setzt die API intern bereits als schnelle Steuerungsschicht ein. Die Teams definieren dafür nur Optionen, statt eigene Klassifikatoren zu trainieren oder auf generative Aufrufe zu warten.
- Gemini Notebook: leitet Anfragen in Echtzeit an die passende Modellstufe und Denktiefe weiter und beantwortet Alltagsanfragen so mit bis zu 40 % geringerer Latenz.
- Stitch: Das Experiment Rapid Canvas erzeugt bespielbare Wireframes eines Produktablaufs in Sekunden und setzt Änderungen per Sprache oder Tippen fast sofort um.
- CC aus Google Labs: wählt in Sekundenbruchteilen aus mehr als 200 Emojis die passende Reaktion.
- Google Search: nutzt die API als Sicherheitsschicht für MCP-Tools, die Angriffe und manipulierte Inhalte erkennt.
Wie das in der Praxis aussieht, zeigt Sundar Pichai in seinem Post zum Start: Stitch Rapid entwirft darin einen kompletten Produktablauf in Sekunden, abgespielt in Originalgeschwindigkeit.
Gemini Decision 1 Benchmarks: stark bei Google, Mittelfeld im Index
Google vergleicht Decision 1 mit GPT-6 Luna von OpenAI, mit Jev 1.14 von TypeSafe, einem auf Klassifizierung und Entscheidungen spezialisierten Modell, und mit dem eigenen Gemini 3.5 Flash-Lite. Die Einzelwerte stammen aus Googles Vergleichsgrafik, die AI Front bei 36Kr aufgeschlüsselt hat; wie bei jedem Start sind es Herstellerangaben. Danach liegt Decision 1 in 7 von 9 Tests vorn.
| Benchmark | Gemini Decision 1 | Vergleichswerte |
|---|---|---|
| JevBench | 92,2 % | GPT-6 Luna 90,9 %, Jev 1.14 90,0 %, Flash-Lite 86,6 % |
| Amazon ESCI (Macro-F1) | 58,7 % | GPT-6 Luna 4 Prozentpunkte, Flash-Lite 11,5 Prozentpunkte dahinter |
| New Yorker Caption | 79,7 % | GPT-6 Luna 68,4 % |
| PubMedQA | 79,8 % | GPT-6 Luna 74,4 % |
| Global-MMLU-Lite | 86,0 % | GPT-6 Luna 79,6 % |
| Mind2Web Multimodal | 86,2 % | Jev 1.14 86,8 % |
| When2Call | 79,9 % | Jev 1.14 82,0 % |
| MMAU (Audio) | 71,8 % | Flash-Lite niedriger |
| Video-MME | 69,1 % | Flash-Lite niedriger |
Beide Niederlagen gehen an Jev 1.14, und eine davon trifft einen Kernbereich: When2Call misst, ob ein Modell richtig entscheidet, wann es ein Tool aufruft. Genau für solche Entscheidungen in Agenten bewirbt Google das Modell. Bei den Gesamtkosten der Aufrufe liegt laut AI Front in Googles Grafik zudem ein Konkurrent vorn.
Deutlich stärker ist Decision 1 beim Kalibrierungsfehler (Top-1 ECE). Er misst, wie gut die angegebene Konfidenz zur tatsächlichen Trefferquote passt. Das zählt für Agenten, weil du nur mit verlässlichen Konfidenzwerten sinnvolle Schwellen für automatische Aktionen setzen kannst.
Kalibrierungsfehler (Top-1 ECE)
| Modell | Wert |
|---|---|
| Gemini Decision 1 | 0,03 |
| Jev 1.14 (TypeSafe) | 0,05 |
| GPT-6 Luna | 0,07 |
| Gemini 3.5 Flash-Lite | 0,21 |
Decision Index: 66 Punkte, sieben hinter der Spitze
Googles Vergleich stammt vom Hersteller selbst. Im unabhängigen Decision Index v2.1 von Artificial Analysis kommt Gemini Decision 1 laut dem Post zum Start auf 66 Punkte. Damit liegt es gleichauf mit Jev 1.14 und Elephant 9B, aber sieben Punkte hinter Drex Max v1.1 und GLiDE v1.2, die sich mit je 73 Punkten die Spitze teilen.
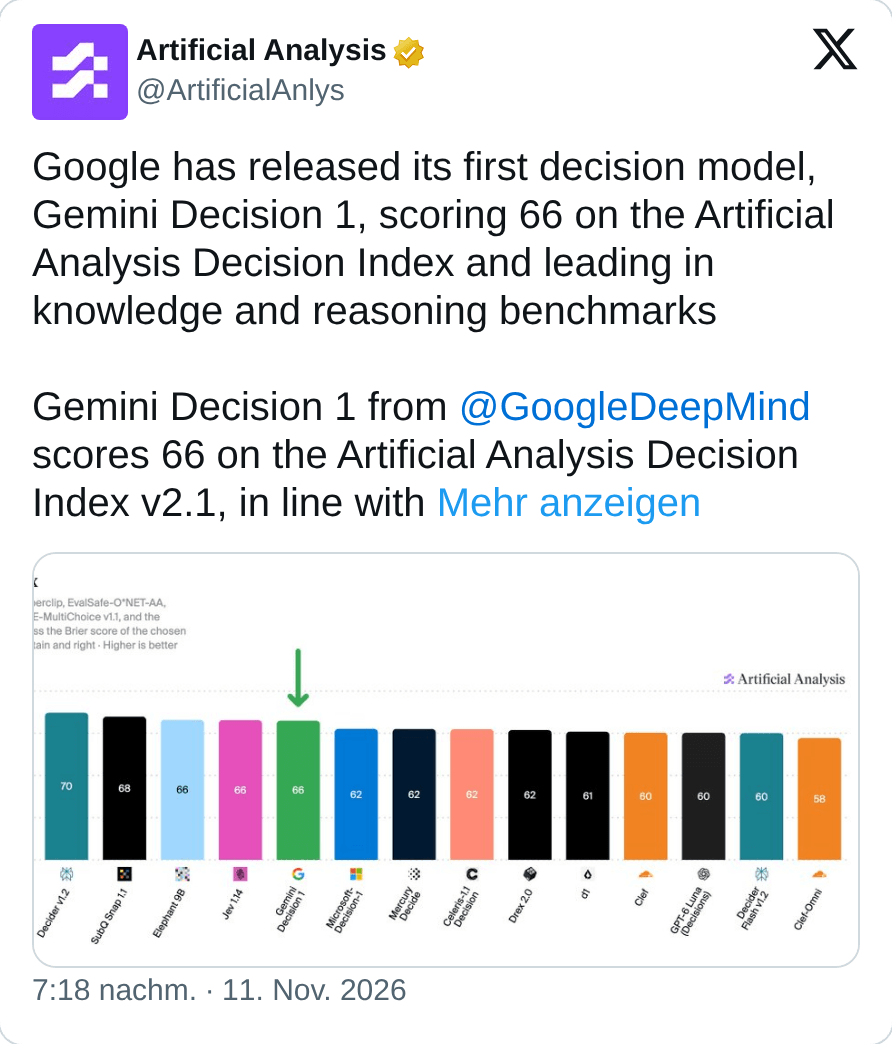
Vorn liegt Decision 1 bei Wissen und Reasoning: Auf AA-Omniscience-Decision erreicht es 66 Punkte, auf HLE-MultiChoice 49. Bei den übrigen Tests liegt es zurück, etwa bei AA-Paperclip, dem neuen Benchmark für Klassifizierung und Extraktion aus Dokumenten, der mit 30 % am stärksten in den Index eingeht. Dort beantwortet Decision 1 nur bei 33 % der Dokumente alle 15 Fragen richtig, Drex Max v1.1 bei 63 %.
Pro Aufgabe ist Decision 1 zudem mehr als dreimal so teuer wie der Spitzenreiter. Über alle Tests des Index kostet es laut Artificial Analysis $345 pro 1 Mio. Aufgaben, Jev 1.14 $156 und Drex Max v1.1 $103. Der Grund ist der Token-Preis: Drex Max v1.1 kostet $0,03 pro 1 Mio. Input-Token, Decision 1 $0,10. Ähnlich teuer wie Googles Modell ist GPT-6 Luna (Decisions) mit $339.
Bei der Kalibrierung, die Artificial Analysis mit dem Brier Score misst, liegt Decision 1 mit 0,18 zwischen Drex Max v1.1 (0,16) und Jev 1.14 (0,19); niedriger ist besser. Je nach Aufgabe schwankt der Wert: Auf HLE-MultiChoice gehört sein Wert von 0,20 zu den niedrigsten im Index, auf When2Call steht 0,14 gegen 0,04 bei Drex Max v1.1. In Googles eigenem Vergleich hatte Decision 1 den geringsten Kalibrierungsfehler, Drex Max v1.1 war dort aber nicht dabei.
| Modell | Decision Index | Brier Score | Kosten pro 1 Mio. Aufgaben |
|---|---|---|---|
| Gemini Decision 1 | 66 | 0,18 | $345 |
| Drex Max v1.1 | 73 | 0,16 | $103 |
| Jev 1.14 (TypeSafe) | 66 | 0,19 | $156 |
Jev und OpenAI: Google ist nicht der Erste
Google betritt mit Decision 1 ein Feld, in dem es schon Spezialisten gibt: Jev von TypeSafe liegt bereits in Version 1.14 vor und ist auf genau solche Entscheidungen ausgelegt. Dass Google gegen Jev 1.14 und OpenAIs GPT-6 Luna antritt, zeigt, wo der Wettbewerb läuft: bei schnellen, günstigen Entscheidungen in Agenten-Pipelines. Nutzt du Jev bereits für Tool-Entscheidungen, liefern Googles eigene Zahlen bei When2Call keinen Grund zum Wechsel; beim Kalibrierungsfehler liegt dagegen Decision 1 vorn.
Gemini Decision 1 in Deutschland verfügbar?
Zum Start läuft Gemini Decision 1 über die Gemini API in Google AI Studio, und zwar nur über die Gemini Developer API in der Version v1beta. Eine Länderliste oder Einschränkungen für die EU nennt Google in der Ankündigung nicht. Für Prototypen gibt es in AI Studio eine kostenlose Stufe.
Über OpenRouter ist das Modell seit dem ersten Tag zum selben Preis zu haben. Integrationen für LangChain, Vercel, LiteLLM, Pydantic AI, Pipecat, LiveKit und OpenCode rollt Google gerade aus. Nutzt du Gemini über Google Cloud, musst du warten: Die Unterstützung dort kündigt Google für bald an.
Gratis-Stufe ist für Prototypen gedacht
Google bewirbt die kostenlose Stufe ausdrücklich zum Prototyping. Rate Limits und Regeln zur Datennutzung nennt die Ankündigung nicht: Prüf die Bedingungen in AI Studio, bevor du echte Kundendaten schickst.
- Schritt 1
API-Key holen Erstelle in Google AI Studio einen API-Key; für erste Tests reicht die kostenlose Stufe.
- Schritt 2
SDK aktualisieren Installiere
google-genaiab Version 3.2 für Python oder JavaScript, alternativ funktioniert REST. - Schritt 3
Beta-Endpunkt nutzen Lege den Client mit der API-Version
v1betaan und rufeclient.decisions.createmitgemini-decision-1auf, wie im Codebeispiel oben. - Schritt 4
Demo-Apps ansehen Google stellt außerdem die Demo-Apps Doorstep Parcels, Speed Sketch und Find the Zoo Keeper bereit.
Wo liegen die Grenzen des Modells?
Das Modell beantwortet nur geschlossene Fragen. Es wählt aus Optionen, die du festlegst, und liefert weder Begründungen noch Fließtext. Für offene Fragen, Zusammenfassungen oder eine Erklärung, warum ein Antrag abgelehnt wurde, brauchst du weiterhin ein generatives Modell. Laut Googles Dokumentation gelten zum Start außerdem diese Einschränkungen:
- Unabhängige Fragen: Hängt eine Entscheidung von einer anderen ab, löst du das in deiner Anwendung, etwa mit einer zweiten Anfrage.
- Nur Text in den Fragen: Anweisungen sind nur als Text möglich, Gesprächsverlauf und Tool-Call-Blöcke werden nicht unterstützt.
- Fehlende API-Funktionen: Context Caching, die Batch API sowie Flex- und Priority-Inferenz gibt es noch nicht.
- Latenz nur bis 16K belegt: Die 150 bis 250 ms gelten laut Google für Kontexte bis 16K Token.
Für die Konfidenzwerte empfiehlt die Dokumentation, Schwellen mit gelabelten Beispielen aus dem eigenen Traffic festzulegen. Bei folgenreichen Aktionen wie Auszahlungen soll ein Mensch oder eine zweite Prüfung beteiligt bleiben.
Für wen lohnt sich die Decisions API?
Interessant ist Decision 1 für alle, die viele kleine Entscheidungen mit festen Antworten treffen: Routing und Tool-Auswahl in KI-Agenten, Regelprüfungen, Spam-Erkennung oder Prüfungen von Fotos und Dokumenten wie Schadensanträgen. Nutzt du dafür heute ein kleines generatives Modell und parst dessen JSON, sparst du laut Googles Zahlen Latenz und Output-Kosten. Wo Nutzer eine Begründung sehen sollen, bleibt das generative Modell nötig.
Vorteile
- KostenOutput-Token kosten nichts, und den gemeinsamen Input zahlst du pro Anfrage nur einmal, egal wie viele Fragen du stellst.
- TempoLaut Google 150 bis 250 ms Ende-zu-Ende bei Kontexten bis 16K Token, nahezu gleich bei einer oder 100 Fragen.
- KalibrierungMit einem Top-1 ECE von 0,0250 passt die Konfidenz in Googles Vergleich besser zur Trefferquote als bei Jev 1.14 (0,0494) oder GPT-6 Luna (0,0721).
- MultimodalAudio, Video und PDF verarbeitet das Modell direkt, ohne separate Kosten für Transkription oder OCR.
Nachteile
- Keine BegründungenDas Modell wählt nur aus vorgegebenen Optionen und schreibt keinen Text.
- Tool-CallsBei When2Call liegt Jev 1.14 mit 82,0 Prozent vor Decision 1 mit 79,9 Prozent.
- Früher ZugangZum Start gibt es das Modell nur über die v1beta der Gemini Developer API, Google Cloud folgt erst später.
- Fehlende FunktionenContext Caching, Batch API und Gesprächsverlauf werden laut Dokumentation noch nicht unterstützt.
Häufige Fragen zu Gemini Decision 1
Was kostet Gemini Decision 1?
$0,10 pro Million Input-Token, Output-Token kosten nichts. Den gemeinsamen Input zahlst du pro Anfrage nur einmal; bei OpenRouter gilt derselbe Preis, und in AI Studio gibt es eine kostenlose Stufe für Prototypen.
Kann Gemini Decision 1 Antworten begründen oder Text schreiben?
Nein. Das Modell wählt nur aus vorgegebenen Optionen und liefert Wahrscheinlichkeiten und einen Konfidenzwert. Für Begründungen kombinierst du es mit einem generativen Modell, an das du unsichere Fälle weitergibst.
Gibt es Gemini Decision 1 über Vertex AI und Google Cloud?
Noch nicht. Zum Start läuft das Modell über die Gemini API in Google AI Studio (v1beta) und über OpenRouter; Unterstützung für Gemini in Google Cloud kündigt Google für bald an.
Was unterscheidet Decision 1 von Gemini 3.5 Flash-Lite?
Gemini 3.5 Flash-Lite erzeugt Text, Decision 1 bewertet nur vorgegebene Antworten. Über Googles Benchmark-Suite ist Decision 1 laut Google fast fünfmal günstiger und deutlich besser kalibriert (Top-1 ECE 0,0250 statt 0,2104).